この記事の内容はほとんど この動画 を参考にしています
はじめに
使うもの:
- Stable Diffusion 統合パック:https://www.bilibili.com/read/cv22159609/
- Stable Diffusion モデル:https://tusi.cn/models/605039709506335625
- LoRA モデル:https://tusi.cn/models/620507699483853069
具体的な手順
まず、適切な写真を1枚選びます。被写体と内容がはっきりしていて、細部は必要ありません。私が選んだのはこの写真です。
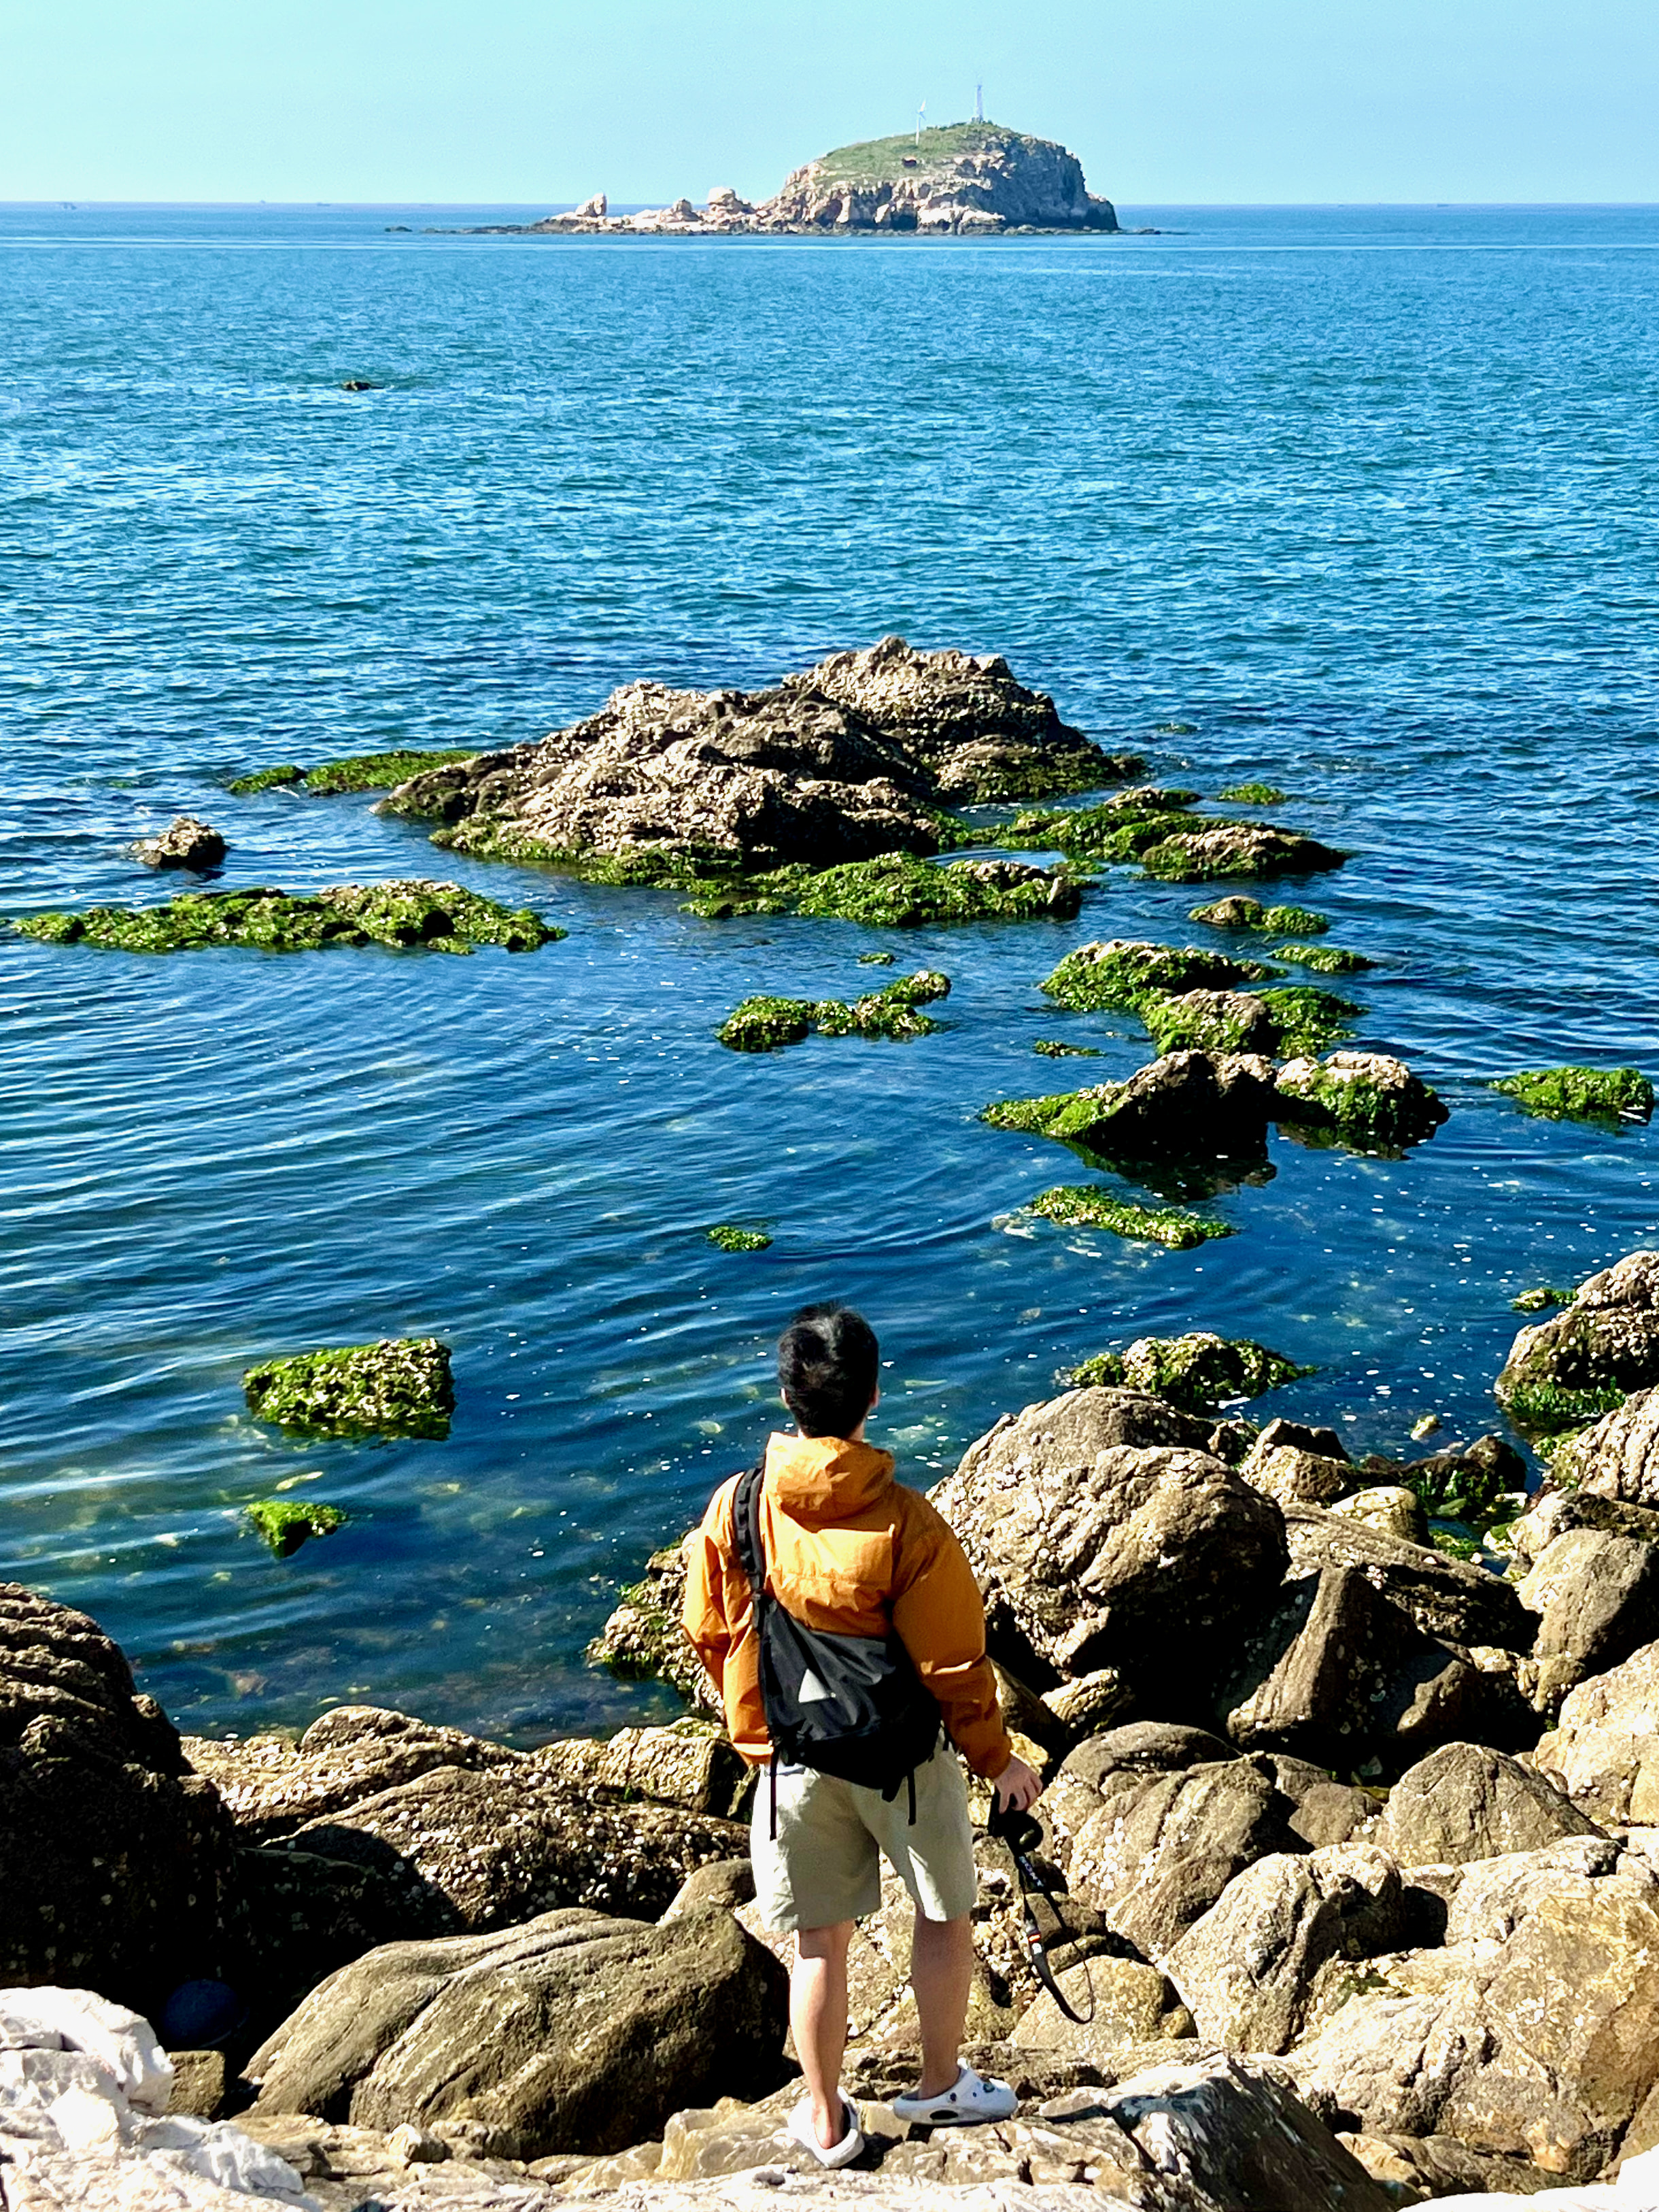
私が選んだ写真動画のとおりに、img2img に以下のプロンプトを入力します。
PROMPT(white background:1.1),(simple background:1.1),(chibi),thick outline,happy,mugshot写真を
WD 1.4 タガーにかけると、次のプロンプトが得られました。CodeBlock Loading...これらのプロンプトを img2img に入力し、一部を削除します。
画像を生成ウィンドウの img2img タブに読み込み、以下のパラメータに変更します。
パラメータ 値 サンプリング方法 (Sampler) DPM++ 3M SDE ステップ数 (Steps) 30 ノイズ除去強度 0.7 バッチ数 4 「生成」をクリックすると4枚の画像が生成されます。結果に応じて
ノイズ除去強度を調整します。目安は0.6〜0.7で、満足できる画像ができるまで調整してください。気に入った画像と生成パラメータを後処理タブに送り、
アップスケーラー 1 と 2はどちらもR-ESRGAN 4x+ Anime6Bに、拡大率は4に設定して、「生成」をクリックします。最終的に、こんな画像ができました。
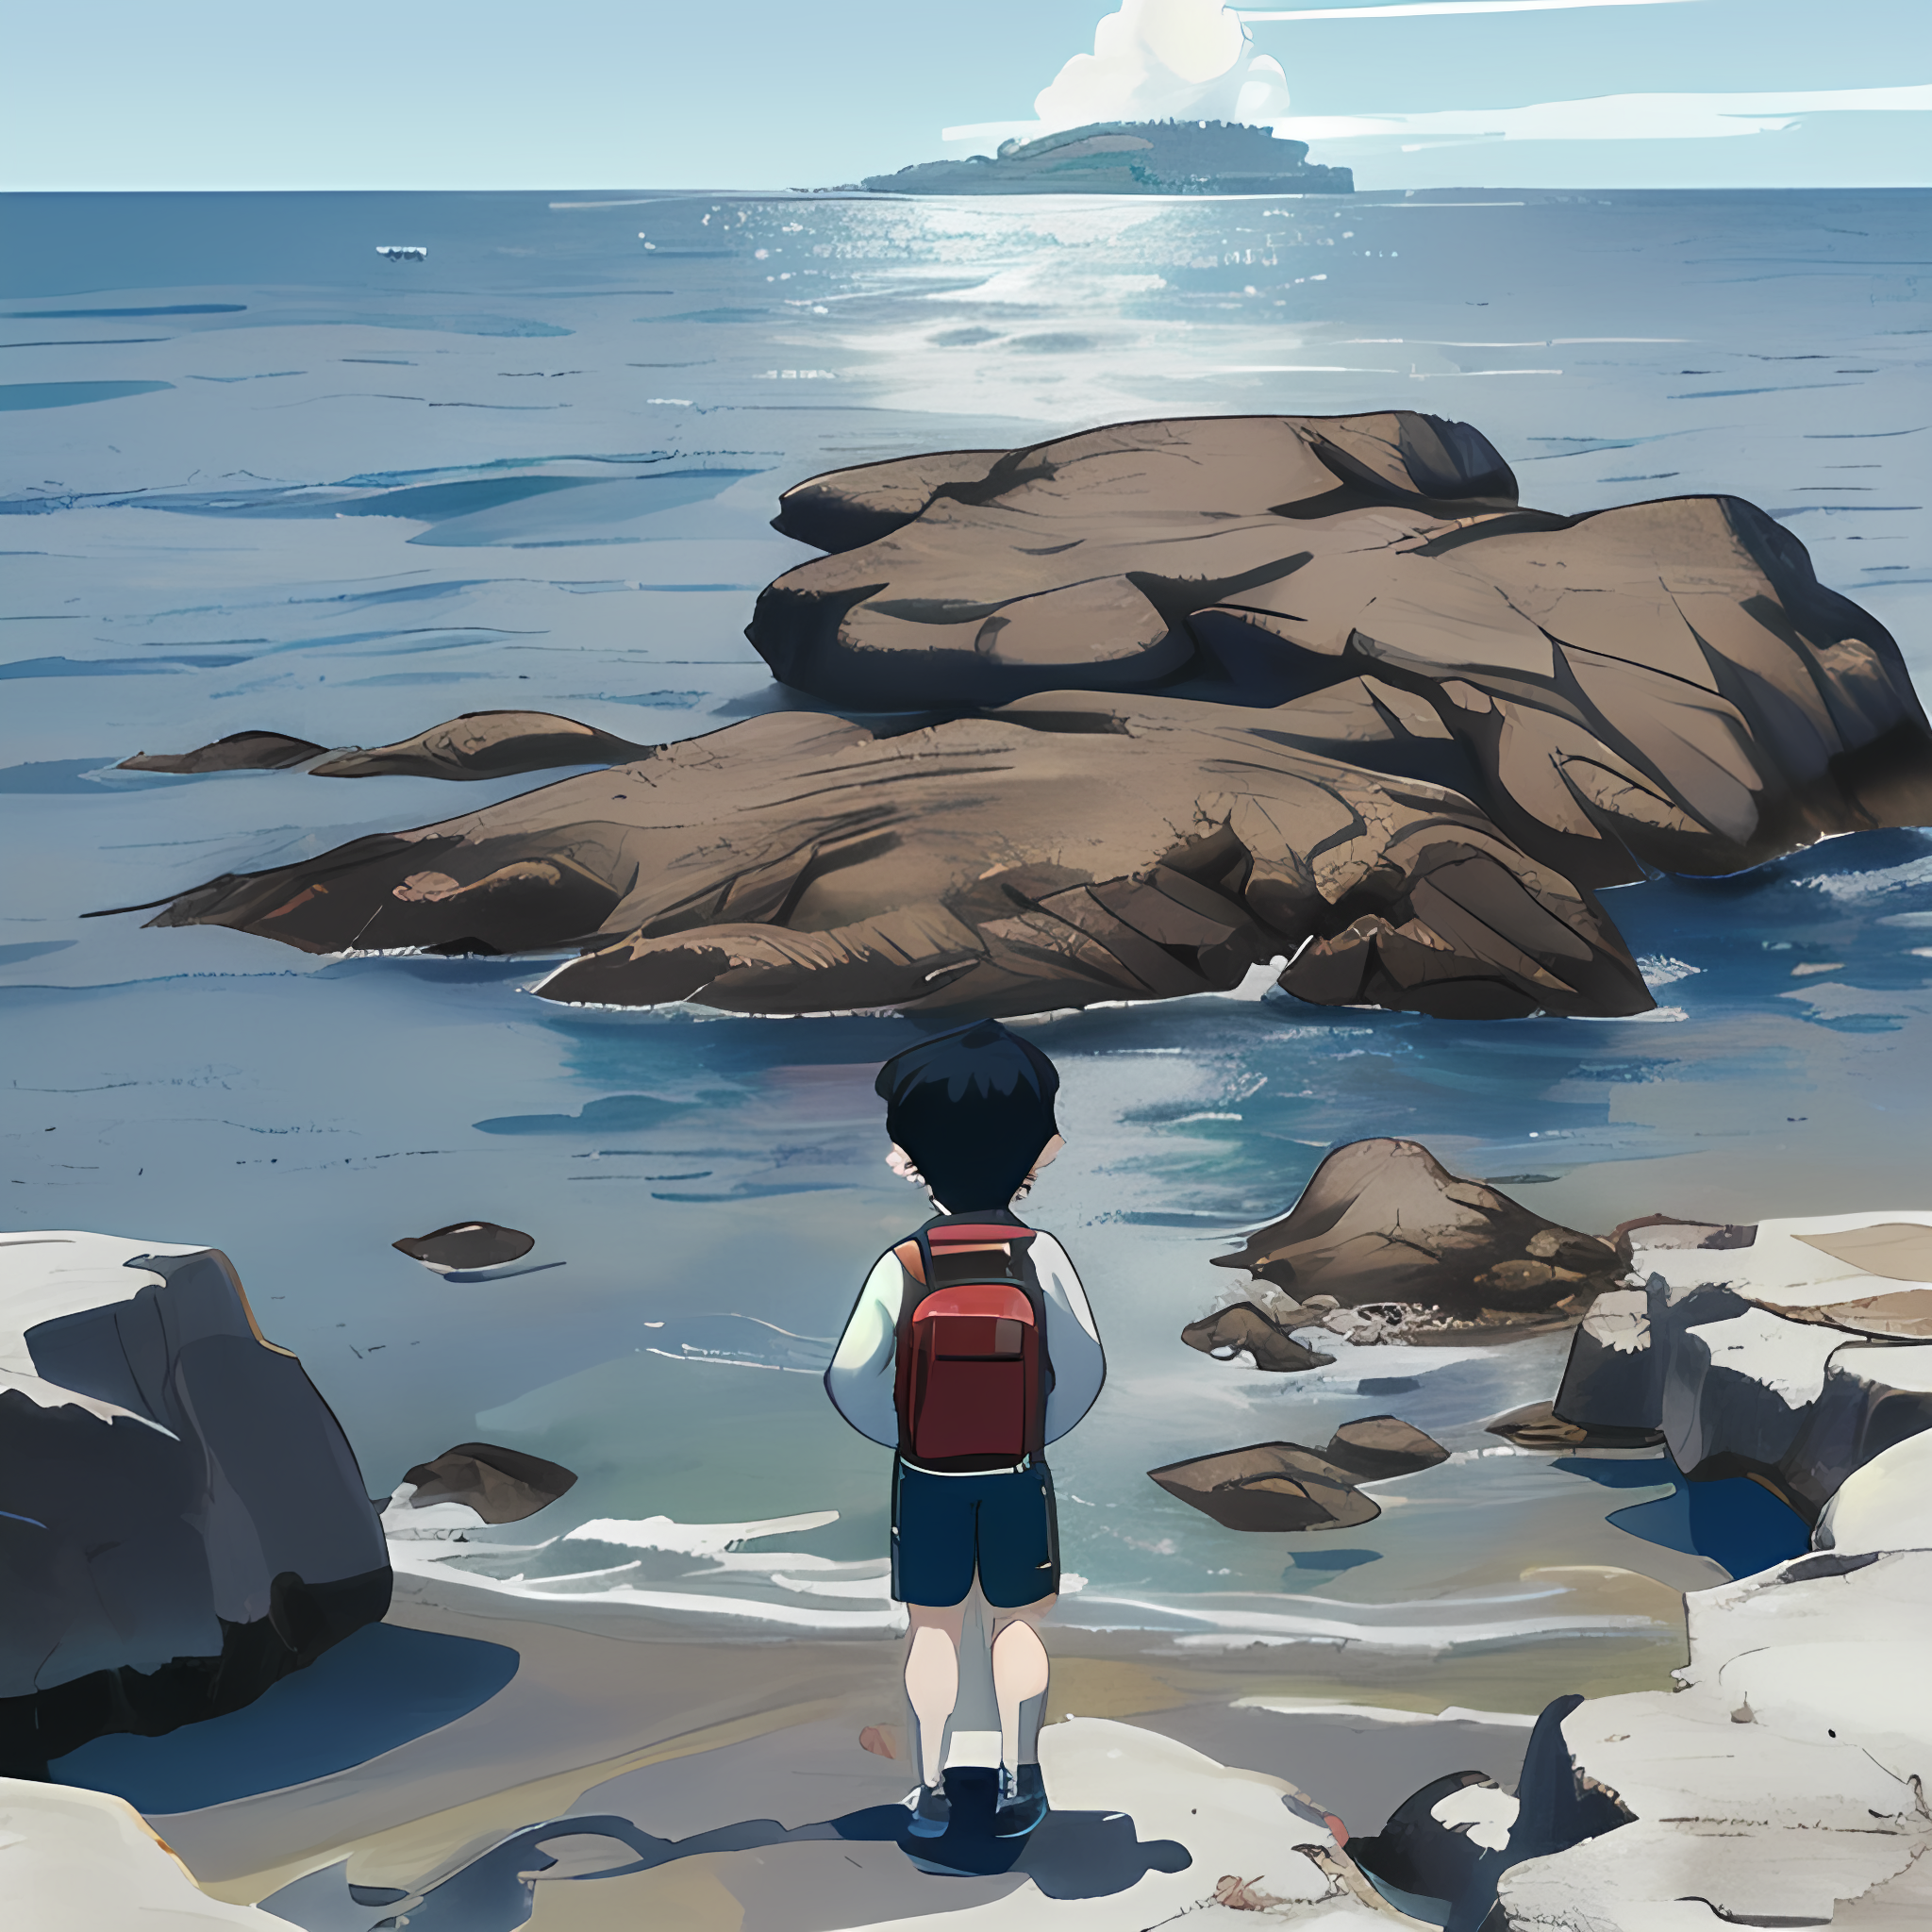
最終的に生成された画像
比べてみましょう。
